WAYS OF WORKING · 2026.08.26
ChatGPT 重做了搜索工具,我读懂了它的新“语言”
从工具调用的变化出发,拆解 ChatGPT 如何搜索、核查网站,以及这对 AI 搜索可见性意味着什么。
原文作者: Suganthan Mohanadasan 发布日期: 2026 年 8 月 21 日 原文链接: <https://suganthan.com/blog/chatgpt-new-search-language/> 标签: GEO、AI SEO、ChatGPT
8 月 16 日到 20 日短短四天里,ChatGPT 的搜索工具从 JSON 改成了一套紧凑的查询语法,还加入了时间范围、指定域名,以及产品、地点、图片、组件等不同的搜索通道。我用同一个账号问了同一个问题,正好记录下变化前后的两种形式。下面我会把这套新语法完整拆开讲清楚,并分析每个部分会怎样影响网站获得 ChatGPT 引用。
8 月 16 日,ChatGPT 帮我搜索网页时,调用格式还是 JSON:
{"system1_search_query":[{"q":"site:intercom.com Fin AI Agent pricing 2026"}]}到了 8 月 20 日,我用同一个账号问同样的问题,调用格式已经变成了这样:
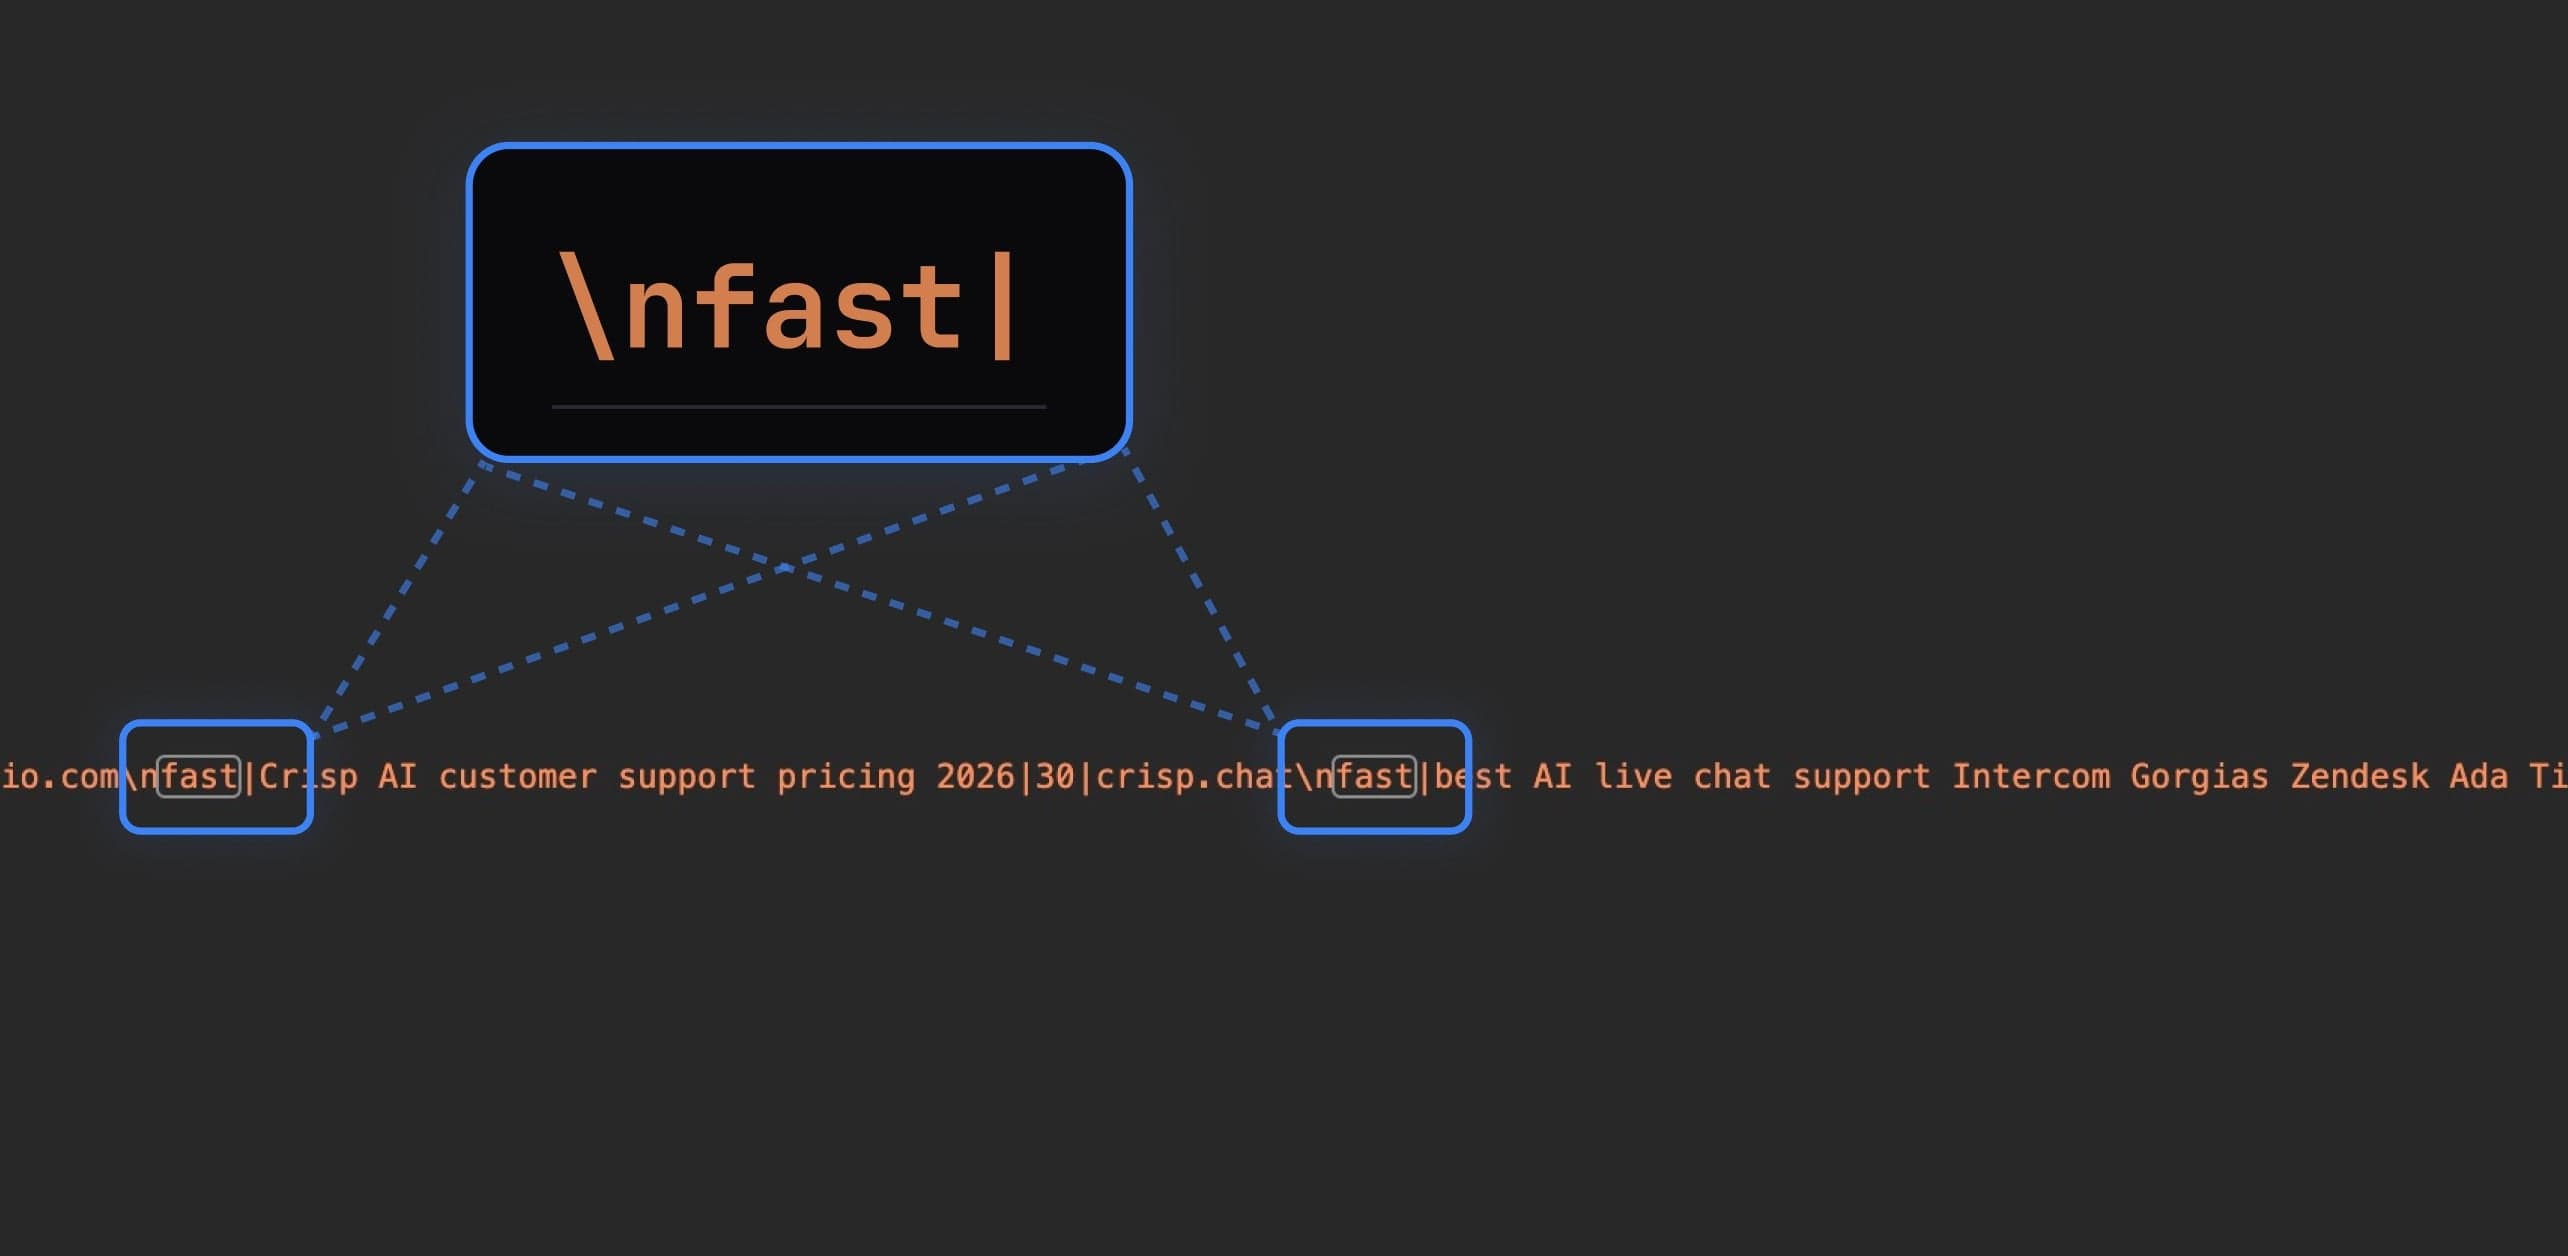
fast|Intercom Fin AI agent pricing 2026 live chat support|30|intercom.com
fast|Gorgias AI Agent pricing 2026 customer support|30|gorgias.com
fast|Zendesk AI agents pricing 2026|30|zendesk.com
fast|best AI live chat support Intercom Gorgias Zendesk Ada Tidio Crisp reddit|365|reddit.com
length|long
也就是说,就在这四天里,OpenAI 用一套自有的紧凑查询语法替代了 JSON。与此同时,`search_queries` 这个字段也从返回数据中彻底消失了。它原本用来记录模型拆分出的扇出查询;我上一篇文章还专门提醒大家查看它,FanoutFox 也依赖它来解析查询。
这是本系列的第 4 篇。第一篇讲的是《ChatGPT 如何选择信息来源》,上一篇则发现,ChatGPT 在真正搜索之前,就已经列好了候选名单。这次我用 8 个问题测试了新格式,覆盖商业调研、实体商品、本地搜索、新闻和金融,想看看这套新语法到底能表达哪些东西。
答案是:比旧格式多得多。
下面是五个环环相扣的发现:
- 每一行都代表一次搜索,各个字段的含义也很直观。
- 第三个字段是时间窗口,会随问题类型而变化。
- ChatGPT 会走不同的垂直搜索通道,内容类型决定它调用哪一种。
- 域名字段表明,ChatGPT 会优先访问自己已经知道的网站。
- 有些答案正在变成内置组件,里面根本没有可争取的引用机会。
本文的所有观察,都来自我在同一地点、用同一个 ChatGPT Plus 账号记录的浏览器网络请求。
发现一:每一行就是一次搜索
现在,一次工具调用会写成多行:一行一次搜索,各字段用竖线隔开。基本结构是“调用类型|查询词|数字”,有时末尾还会再带一个域名。
fast|Zendesk AI agents pricing 2026|30|zendesk.com`fast` 是调用类型。后面的查询词和旧版扇出查询很像:品牌名由模型自己写入,还会带上年份,以及 `pricing`(定价)这类意图词。真正新增、也最值得关注的是数字和域名——旧格式里根本没有地方放这两个参数。
每个查询块最后都会用一条指令收尾:`length|long`、`length|medium` 或 `length|short`。这一项其实是从旧格式继承下来的。本文开头的 JSON 在对应位置写的是 `"response_length":"long"`,所以它只是换了名字,并非新功能。
它应该是在控制每条结果带回多少文字,而且会根据任务调整。深度产品对比用的是 `long`,大多数普通查询用 `medium`,最后只核实两个场所名称时则用了 `short`。如果我的判断没错,多数搜索并不会读取整页内容,而只会截取一段有限长度的摘要。也正因为如此,真正回答问题的那句话,最好放在容易被截取的位置。
查询词后面的字段并非必填。有些行只有查询词,有些会加上数字;只有在指定网站内搜索时,域名才会出现。
实用 AI SEO/GEO 建议
用客户真正会问的问题测试 ChatGPT,看看它在查询里主动写进了哪些品牌。这些品牌,就是它心目中该品类的候选名单;域名字段里的网站,则是它接下来准备访问和核实的对象。
同时也要确认,你的网站经得住这一步核查。我之前写过相关内容,也做过几个工具,可以顺便检查一下。
发现二:第三个字段是时间窗口
下面是我 8 月 20 日测试时,五条查询里这个字段的不同取值:
| 问题 | 查询行 | 数字 |
|---|---|---|
| 英伟达是否估值过高 | `fast | NVIDIA NVDA stock price August 20 2026... |
| 英超周末赛况 | `fast | Premier League results... |
| 最好的 AI 在线客服软件 | `fast | Zendesk AI agents pricing 2026 |
| 英伟达盈利指引 | `fast | NVIDIA latest earnings guidance... |
| 在线客服问题中的 Reddit 查询 | `fast | best AI live chat support...reddit |
股价是 2,足球赛果是 7,商业产品调研是 30,盈利指引则是 90。
这个数字到底代表什么?
我的判断是:它表示以“天”为单位的时间窗口,并会根据答案的过时速度自动调整。
目前我没见过任何官方说明,所以这仍然只是推测。
实用 AI SEO/GEO 建议
在我测试的商业类问题里,所有针对品牌官网的查询都用了 30 天窗口。
如果这个数字确实按天计算,那么定价页或对比页只要超过一个月没更新,在品牌比较类问题中就可能直接落到默认时间范围之外。
因此,直接影响购买决策的页面最好在这个周期内持续更新。更新要有实质内容,也要让日期清晰可见。
核心页面和内容也同理。可以用自己的提示词或关键词跑一遍,看看它们对应的时间窗口是多少。
发现三:ChatGPT 会调用不同的垂直搜索通道
下面是我目前抓到的几种调用类型,以及它们对应的真实查询。
`fast` 就是网页搜索。 它接替了旧版的整套扇出查询。
`product` 用来查商品目录。 我在扫地机器人和床垫类问题中见过它,但测试软件类问题时一次也没出现。
product|Roborock Saros 10R robot vacuum;Dreame X50 Ultra robot vacuum;Eufy E28 robot vacuum这一行只有产品名,用分号隔开,没有其他参数。这和我 6 月在电商结果中看到的商品卡片、商家报价正好对应得上。
对于实体商品,ChatGPT 不只会搜索介绍页面,还会单独查询商品目录。能不能进入这个目录,是另一套规则,和博客内容写得好不好并不是一回事。
实用 AI SEO/GEO 建议
如果你卖的是实体商品,可以看看 ChatGPT 推荐时,是否同时展示商品卡片、价格和商家名称。
出现商品卡片,说明你的产品已经进入 ChatGPT 使用的商品目录;只有文字提及、没有卡片,说明你目前只能靠内容获得曝光。网页优化做得再好,也不会直接改变 `product` 从商品目录里查到的结果。
`business` 用来查地点和商家,而且必须带地理位置。 在一个咖啡店问题中,它一共调用了三次。下面是前两次:
business|Dubai, UAE|specialty coffee Dubai Marina;best coffee Dubai Marina
business|Dubai, UAE||Blends Specialty Coffee;Roast Speciality Coffee, Marina;OLAB Coffee Shop JBR
第一次传入的是搜索短语;第二次则把第一次查到的真实商家名称带进去,再用带引号的 `fast` 搜索逐一核实。
这其实就是“先列候选名单”机制的本地搜索版,只不过候选对象从品牌换成了线下商家。
如果你做的是本地生意,优化重点应该放在地点数据库里的商家实体上。
地点查询负责给出名称、评价和商家信息,网页搜索只是进一步核实。
可以让 ChatGPT 搜索你所在地区的相关品类,然后重点看第二次 `business` 调用。
如果你的店名出现在里面,说明地点系统已经收录了你,后续搜索只是在核对详情。这时要做的是确保官网与各个平台上的商家信息一致。如果店名根本没有进入这次调用,问题就出在地点数据本身,单改网站解决不了。
`image` 就是图片搜索。 例如:`image|Dubai Marina specialty coffee shop|30`。它会和地点查询一起触发。
`genui_run` 会通过 JSON 参数调用内置组件。
genui_run|epl_schedule|{"fn":"schedule","league":"EPL","date_from":"2026-08-21","date_to":"2026-08-24","locale_override":"en-GB"}
genui_run|stock_chart|{"ticker":"NVDA","asset_type":"equity","market":"USA","locale_override":"en-US"}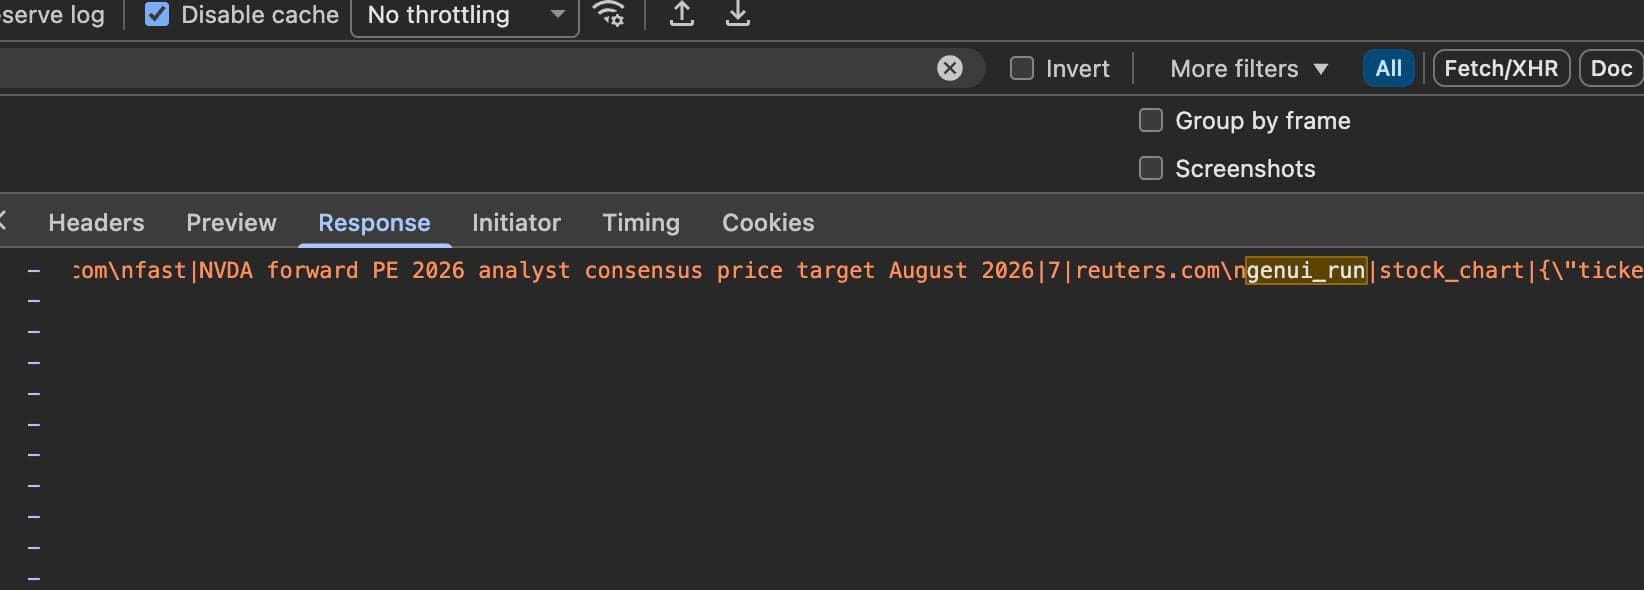
足球赛程和股票图表都是通过带明确参数的函数直接调用,并不是网页搜索。它的影响,我会在第五个发现里继续讲。
新闻测试里还有一个细节:域名字段可以一次填写多个网站。有一行出现了 `theguardian.com;skysports.com`,说明同一次搜索可以同时限定多个媒体来源。
发现四:域名字段让定向核查变成了标准动作
在本周之前,ChatGPT 要搜索某个特定网站,会在查询词前加上经典的 `site:intercom.com`,也就是 SEO 从业者常用的站内搜索运算符。
新格式把域名单独列成了一个字段。只要在每行末尾填入网站,搜索就会限定在这个站点内。换句话说,核查某家公司官网如今已经成了搜索行自带的标准能力,不必再把域名硬塞进查询词。
目前两种写法仍然并存:有些查询还保留 `site:`,另一些已经改用独立的域名字段。
实际流程和上一篇文章的结论一样:模型还是会在抓取内容之前先点出一批品牌,再去各自官网核实信息。
变化在于,这一步现在已经彻底标准化了。访问刚被点名的品牌官网,成了每条搜索都可以直接执行的动作;模型会根据记忆中与品牌对应的域名,自动把网站填进去。
如果模型记错了域名,或者记忆已经过时,它就会搜错网站。我确实见过一次:定向查询指向了一个并非该品牌运营的域名,最后靠更宽泛的搜索才把品牌找回来。
当我问 `best llm visibility tool and what does each one cost`(最好的 LLM 可见性工具有哪些,各自多少钱)时,模型写出了这条查询:
site:profound.ai pricing AI visibility platform Profound pricing 2026Profound 的官网并不是 `profound.ai`,而是 `tryprofound.com`。这次定向查询没有从检索池里找到任何页面,但 Profound 最终还是留在了答案中:更宽泛的探索性搜索找到了正确域名,`tryprofound.com` 的定价页也获得了引用,Profound 在正文里一共被提到六次。也就是说,填错域名只是白白浪费了四次搜索中的一次。
实用 AI SEO/GEO 建议
查看自己的抓包记录,确认域名字段里填的确实是你在运营的网站。品牌更名、网站迁移和国家/地区域名最容易出错,因为模型靠记忆填写,而记忆往往跟不上变化。
在我观察到的这次案例里,搜错一次并没有影响品牌最终入选。但不能指望宽泛搜索每次都来救场。
发现五:有些答案正在变成内置组件
`genui_run` 返回的不是网页,而是直接可用的界面组件。
在金融问题中,股票图表以 `stock_chart` 的名字出现,实际指向托管在 `cdn.platform.openai.com` 上的 2.0 版组件,界面由状态数据渲染生成。咖啡店问题也一样:模型在答案里输出 `genui` 指令,生成一张带地点标记的地图,并把标记和地点查询找到的商家对应起来。
这意味着,在体育、股票、地点等领域——也可能还有更多我尚未发现的场景——答案的一部分已经交给 OpenAI 自己的组件来呈现。股票图表里没有可争取的链接,足球赛程也不会引用某个赛程页面。
越来越多查询正在转向这种不提供外部引用的结果形式,而“有没有获得引用”,恰恰是所有 GEO 工具都在追踪的指标。
实用 AI SEO/GEO 建议
把目前能给你带来排名或流量的查询重新跑一遍,看看哪些答案已经从普通文本换成了组件。抓包记录里出现 `genui_run`,就是最明显的信号。
我没法告诉你怎样在组件里“获胜”,因为就目前所见,里面根本没有链接或引用机会可争取。能做的,是尽早找出哪些查询已经转向组件,并把它们从“潜在引用机会”中剔除。
如果你的流量依赖“比赛几点开始”这类信息,那么现在真正和你竞争的,已经是这个组件。
这和放弃一个已经被 AI Overview 及各种搜索功能挤满的关键词,本质上是同一种取舍。
Reddit 这件事,非常非常有意思
接下来我会一步步拆解这个案例,并把亲眼看到的事实和个人判断分开来说。
先看实时聊天记录中的这条查询:
fast|best AI live chat support Intercom Gorgias Zendesk Ada Tidio Crisp reddit|365|reddit.com仔细看:查询词里直接写了 Reddit,域名字段也指向 `reddit.com`,时间窗口是 365;而同一轮调用里的品牌查询,窗口全是 30。更关键的是,六个品牌名也被一起写进了查询。
那么,这里到底发生了什么?
那一刻我真的像 Joey 一样突然反应过来了。(看过《老友记》的朋友应该懂。)
它不是在问 Reddit:“哪些在线客服工具最好?”而是在问:“大家怎么看模型已经选好的这六款工具?”
也就是说,候选名单来自模型记忆;抓取 Reddit,是为了收集外界对这份名单的评价。
接下来还有一个确定无疑的事实。
这次对话的检索池共有 221 条记录,其中 84 条来自 Reddit,比任何其他来源都多。整个过程中没有打开帖子阅读全文,因此模型拿到的是 84 条搜索摘要——标题加摘录——而不是 84 篇完整帖子。
可最终答案里的所有引用都给了供应商官网。我逐行对照了检索池和引用结果:这 84 条 Reddit 内容,一条都没有被引用。
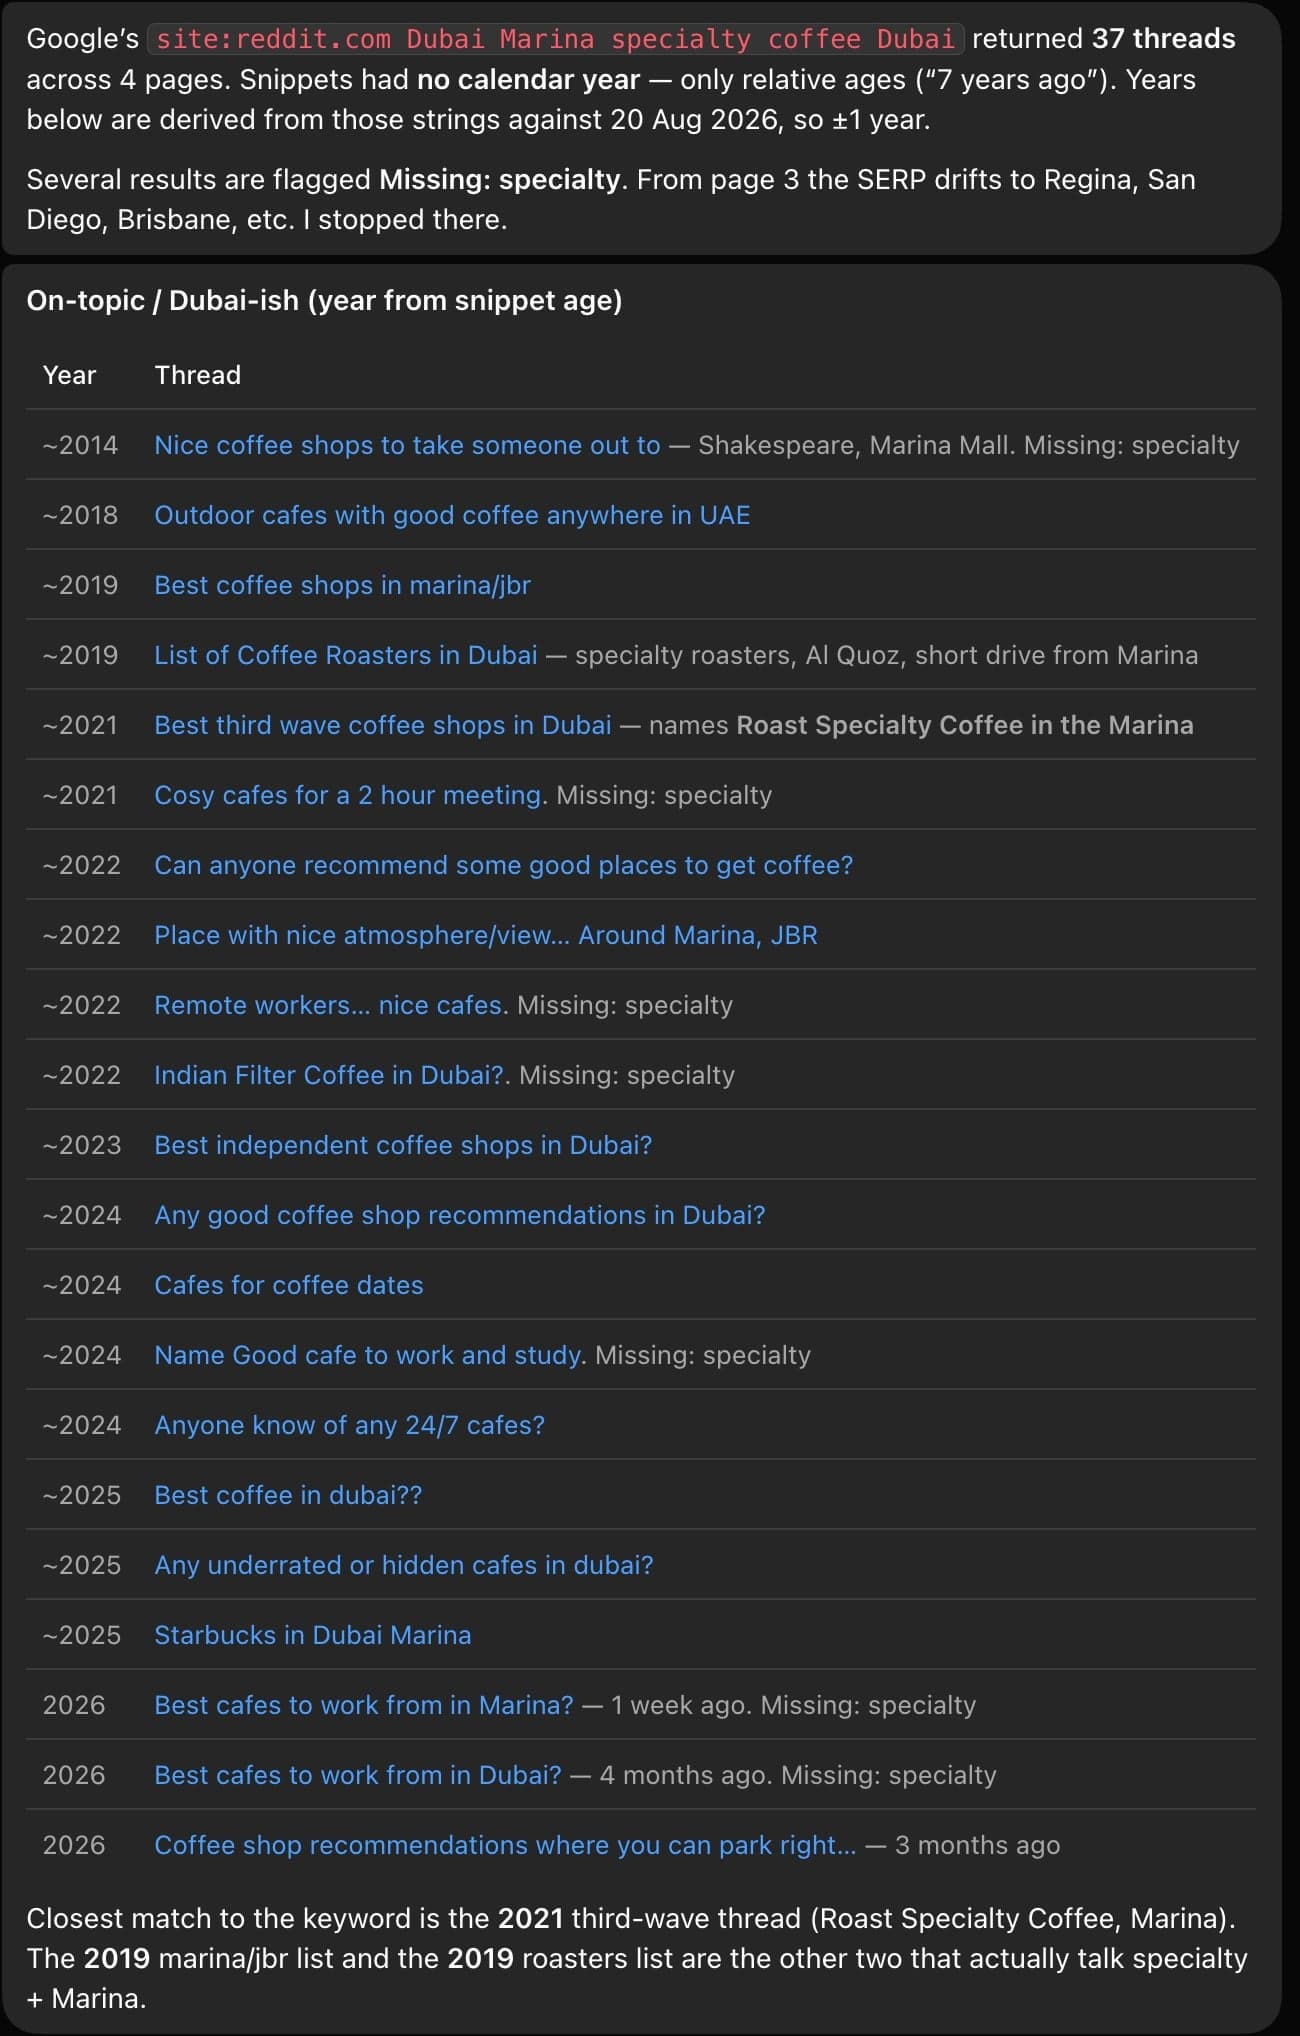
咖啡店的测试又出现了同样的情况,而且更夸张:
fast|site:reddit.com Dubai Marina specialty coffee Dubai|3650|reddit.com两种限定方式同时用上了:查询词里有 `site:`,域名字段又填了 Reddit,时间窗口更是长达 3650 天。同一个问题里,新闻网站只有 7 天,而 Reddit 得到了整整 10 年。
为什么一个本地搜索问题会给 Reddit 十年窗口,我也说不准,后面会讲几种可能。有一点倒能解释为什么这里需要拉长时间范围:我让自己的 AI 智能体去 Reddit 搜 Dubai Marina 咖啡店,结果找到了十二年前的帖子。3650 天正好能覆盖这类历史内容。
不过,单看网络请求仍然无法确认这些结果到底有多旧。我抓到的 Reddit 条目几乎都不带日期,所以无法判断 ChatGPT 实际拿到了哪些年份的帖子。
Promptwatch 8 月 18 日发布的图表显示,8 月中旬,Reddit 在 ChatGPT 引用中的占比从约 3.83% 骤降到不足 1%。他们推测,ChatGPT 可能调整了来源选择机制。
不过,引用统计只能看到最终答案;抓包数据则补出了前面的过程:模型主动搜索 Reddit,批量拿到结果,最后却一条都没引用。
结合这些现象,我有一个判断。但目前还无法证实,所以请把下面的内容看作对证据的解读,而不是定论。
- 放进模型上下文的内容,可能会影响它最后怎么写。(这种偏向并不少见。)
- 模型在评价候选名单之前,刚刚抓取了外界对这些候选项的看法,却没有把最后的评价归因给任何来源。
- 我的判断是,Reddit 正在变成一种“隐形输入”:它可能影响结论,但引用和功劳都落到了供应商官网。
- 这与本系列第一篇文章的发现一致:事实往往来自官方页面,评价则来自第三方,而 Reddit 是其中最重要的来源之一。如果这种分工还在,只是不再显示引用,那么影响可能依旧存在,只是证据链不见了。
- 当然,也可能这些摘要抓回来后根本没被使用,一年的宽窗口只是遗留习惯。抓包数据无法区分这两种情况。我能证明的只有“它抓了”和“它没引用”;至于是否真的影响答案,仍然只是推断。没有引用,单靠网络请求无法证明影响力。
再往下想一步:OpenAI 为什么可能会这样改?
防操纵、减少垃圾内容
一种可能,是降低通过操纵 Reddit 影响 AI SEO/GEO 的效果。如果 ChatGPT 会主动回看 Reddit 过去 1 到 10 年的内容,那么近期人为制造的信号就会被大量历史内容稀释。
这里似乎有两层筛选:先确定候选名单,再去 Reddit 收集评价或进行验证。这样一来,单纯在 Reddit 上大量刷品牌提及,就很难奏效。
它还可能带来一种威慑效果:当引用研究显示 Reddit 的可见度大幅下滑,营销人员会觉得这个渠道“不值钱了”。越少人觉得有利可图,垃圾内容自然越少。
合规或数据授权
背景是,OpenAI 和 Reddit 在 2024 年签署了数据授权协议,因此 OpenAI 付费使用这些数据并不是秘密。至于协议对署名和引用有何要求,单从网络请求里看不出来。
还有一种可能——当然也只是猜测——OpenAI 仍想利用 Reddit 数据,却不希望在答案中频繁、醒目地直接引用 Reddit。
也就是说,Reddit 页面可能不再被突出展示,而是退到更上游,参与候选评估、意见收集或其他内部检索流程。
实用 AI SEO/GEO 建议
如果 Reddit 一直是你做 AI 可见性的重要渠道,请自己数一数还剩多少“筹码”:重新跑一遍核心查询,看看你投入资源经营的帖子是否还会被引用。
这是不是说明 Reddit 营销已经没用了?当然不是。
如果你长期认真参与 Reddit 社区、踏实建设品牌,尤其还经受住了最近一轮垃圾内容清理,那就继续做。不管这次变化背后的原因是什么,Reddit 至少还有两种价值:多年积累的帖子可能进入训练数据,帮助模型形成最初的品牌候选名单;而真正阅读这些帖子的用户,也一直都是潜在买家。
真正缩水的,是可以直接量化的引用回报,也就是前面说的“筹码”。
但如果你的做法只是往 Reddit 灌垃圾内容,试图操纵 AI 可见性,那这显然是个坏消息。
记住:帖子被抓取,却从未被引用,不能算成一个可量化的成功。它是否还会暗中影响答案,目前仍没有定论。
旧方法哪里失效了,以及我接下来会怎么做
旧方法已经失效。 我上一篇文章建议大家打开 DevTools,在响应里搜索 `queries`。现在这个字段已经没了。查询本身还在,只是被挪到了 `web.run` 工具调用消息中,变成前面看到的竖线分隔格式。FanoutFox 目前也在读取旧字段,我会尽快修复。
现在可以用下面这套方法,两分钟就能检查完:
- 用 Chrome 打开 ChatGPT,同时打开 DevTools 的 Network(网络)面板。
- 问一个客户真正会问的商业问题。
- 用 `conversation` 过滤请求。
- 点开体积最大的那条响应,也就是完整的对话数据。不要误点同名但体积很小的 `stream_status` 和 `textdocs`。
- 进入 Response(响应)标签页,在内容区域内按 `Cmd+F`,搜索 `fast|`。
- 不要用 DevTools 的全局搜索,否则会被大量 JavaScript 文件淹没。一定只搜这一条响应。
- 阅读查询行,重点看三件事:有没有你的品牌、域名字段是不是你的网站,以及你的品类使用了多长的时间窗口。
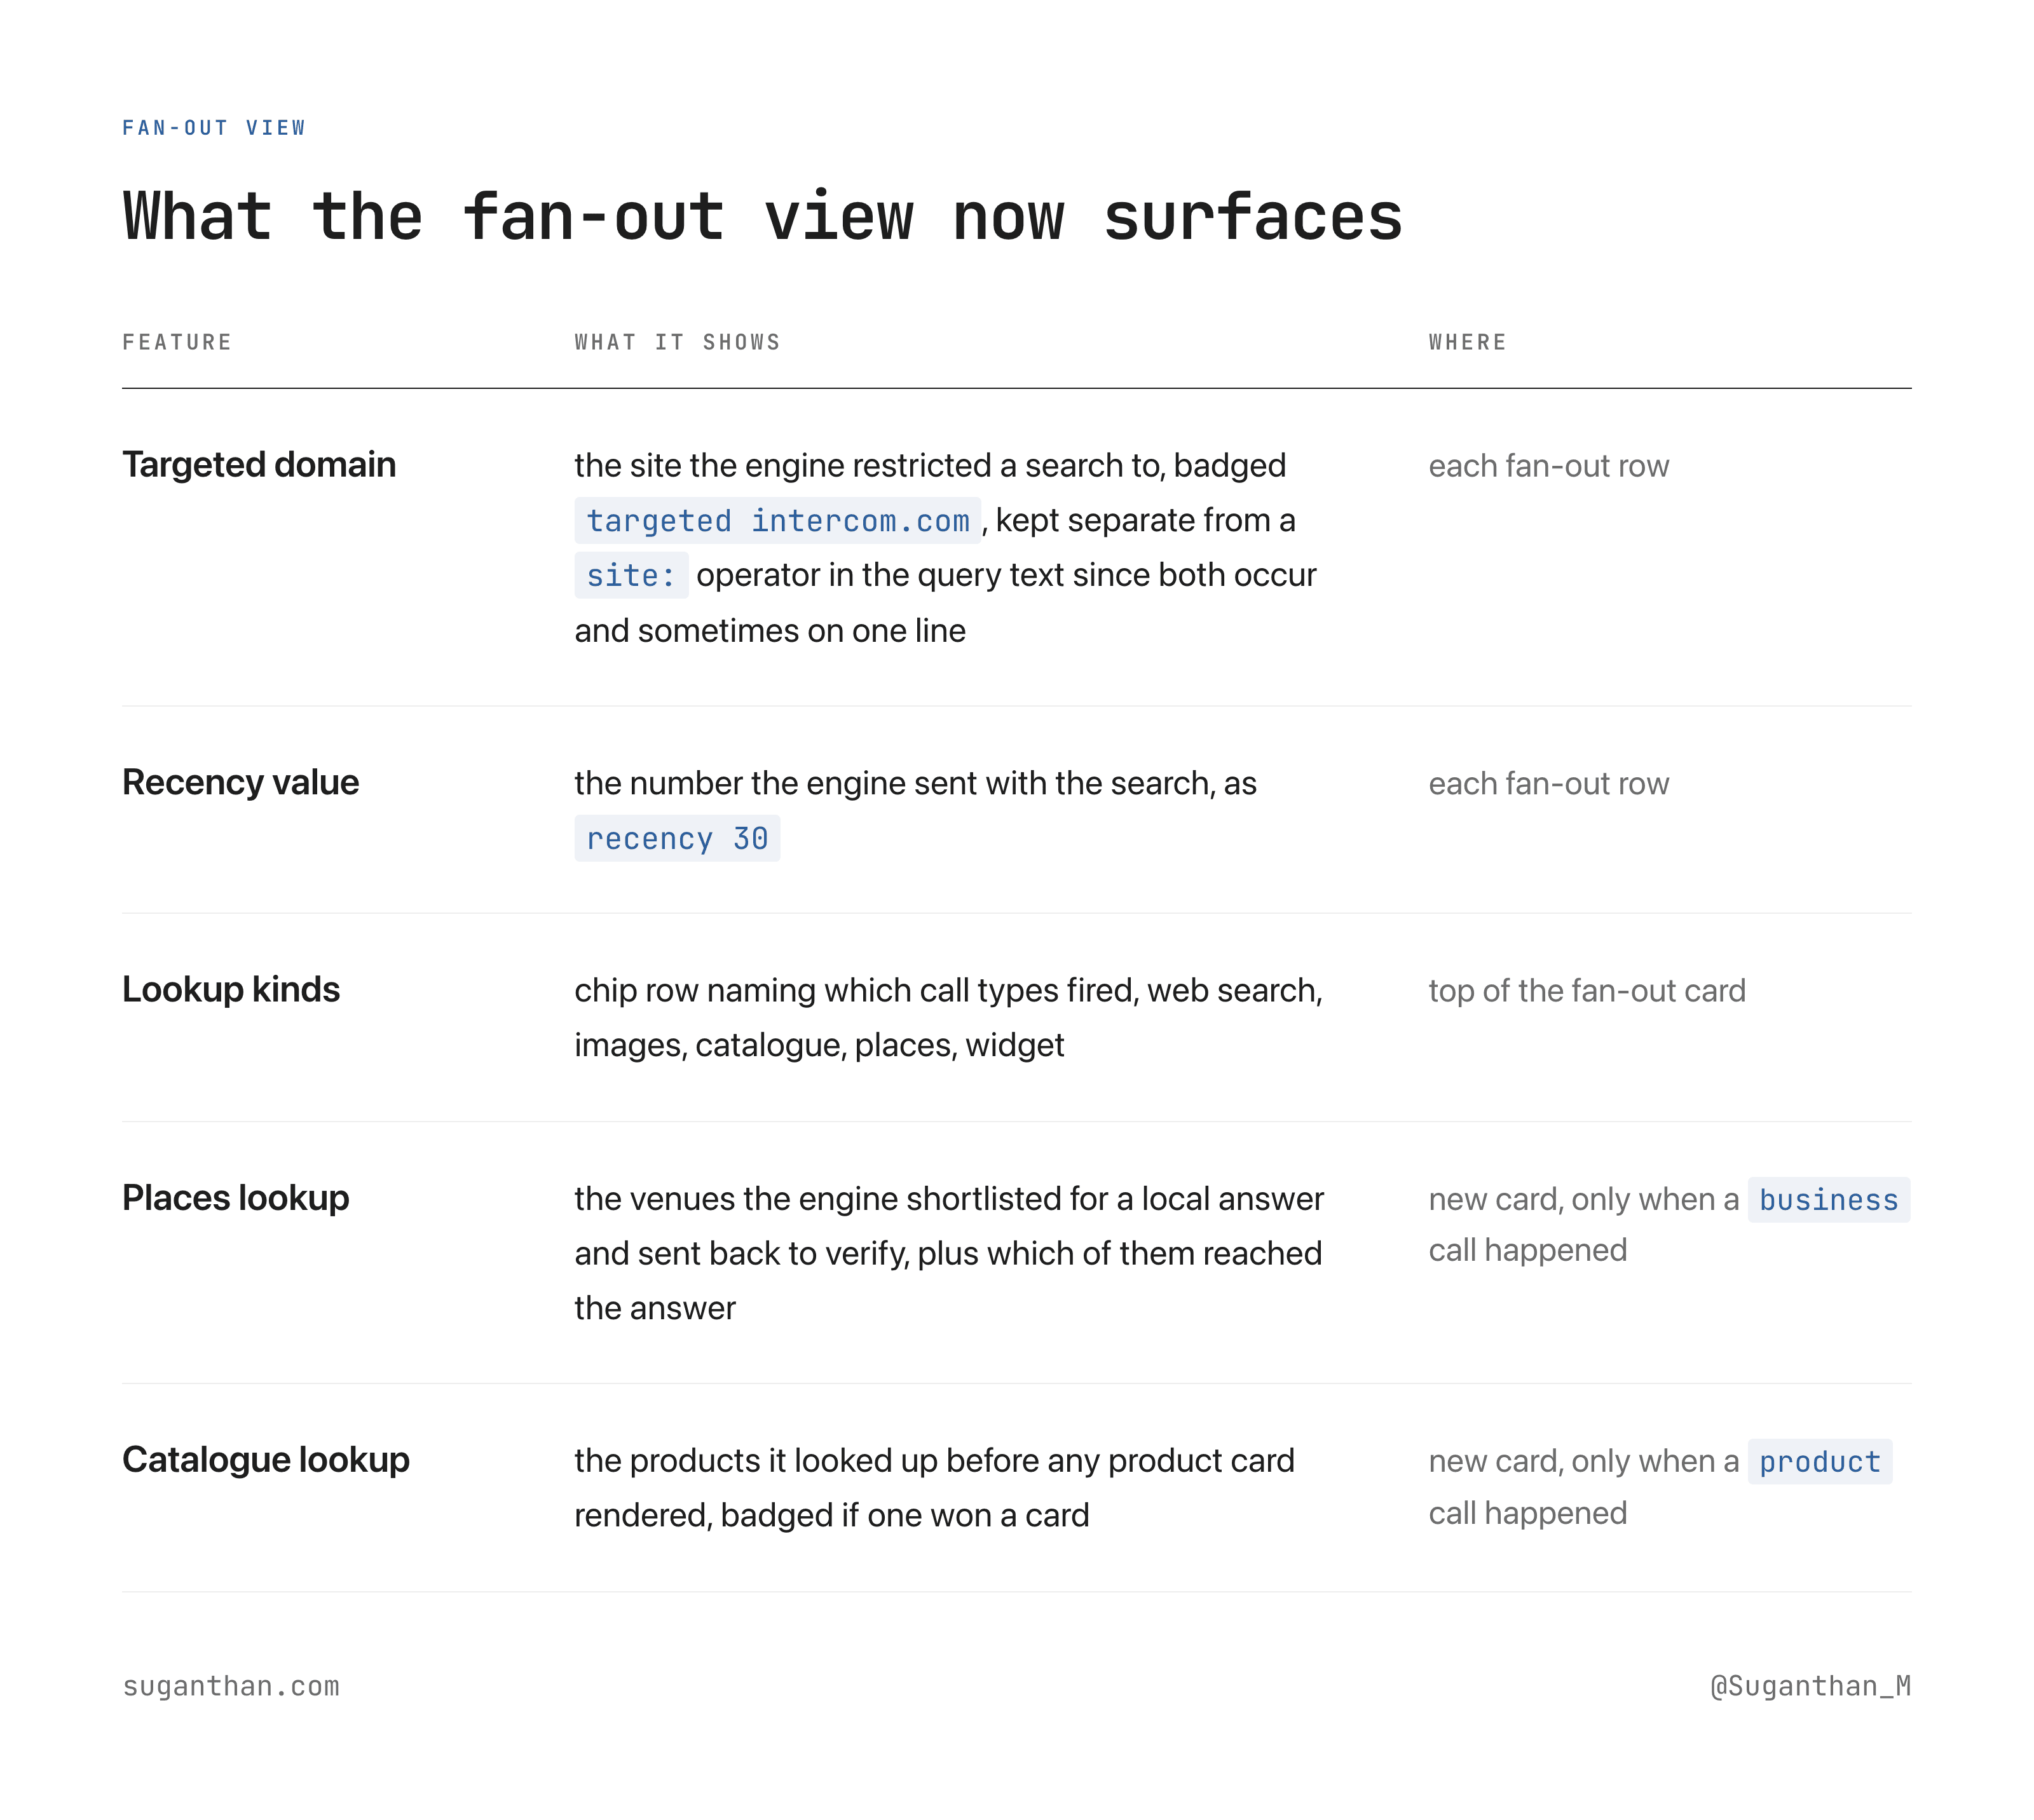
手动查当然可以,但查到第三个答案时就开始烦了。FanoutFox 是我为这个系列做的免费 Chrome 扩展,可以读取同一份会话数据,并按域名、按答案统计哪些来源被抓取、哪些最终获得了引用。
其中的 `converts` 列,会把本文这种 Reddit 检查整理成可排序的表格。Fan-out 卡片目前仍读取旧的 `search_queries` 字段,所以在支持竖线格式的补丁发布前,新对话里的这张卡片会暂时为空;不过来源、引用和域名雷达等其他功能不受影响。
我还需要一点时间更新 FanoutFox,让它适配这些变化。
孩子们正在放暑假,所以我的开发环境里还有三位异常执着、完全不把 Sprint 规划当回事的“利益相关者”。
我会尽快更新。
这是我从 6 月以来记录到的第三次格式变化。这次之所以能把时间范围缩小到四天,是因为我一直会保存带日期的网络请求快照,并在每次测试后逐一对比。
如果你也在做类似研究,一定要把每次记录按日期保存好。星期天还成立的结论,到了星期四可能就已经过时了。